装个能聊天的插件,并不等于笔记会自己长成体系。很多人打开 Obsidian 的库,发现还是:收件箱堆着半截摘录,双链断在半路,真正要写东西时又回去搜聊天记录。AI 能帮你摘要、改写、搭大纲,但若缺一条清晰流程,它更容易把库搅得更乱——你让它「优化」一篇原文,结果关键被改、出处丢了,检索时再也对不上。
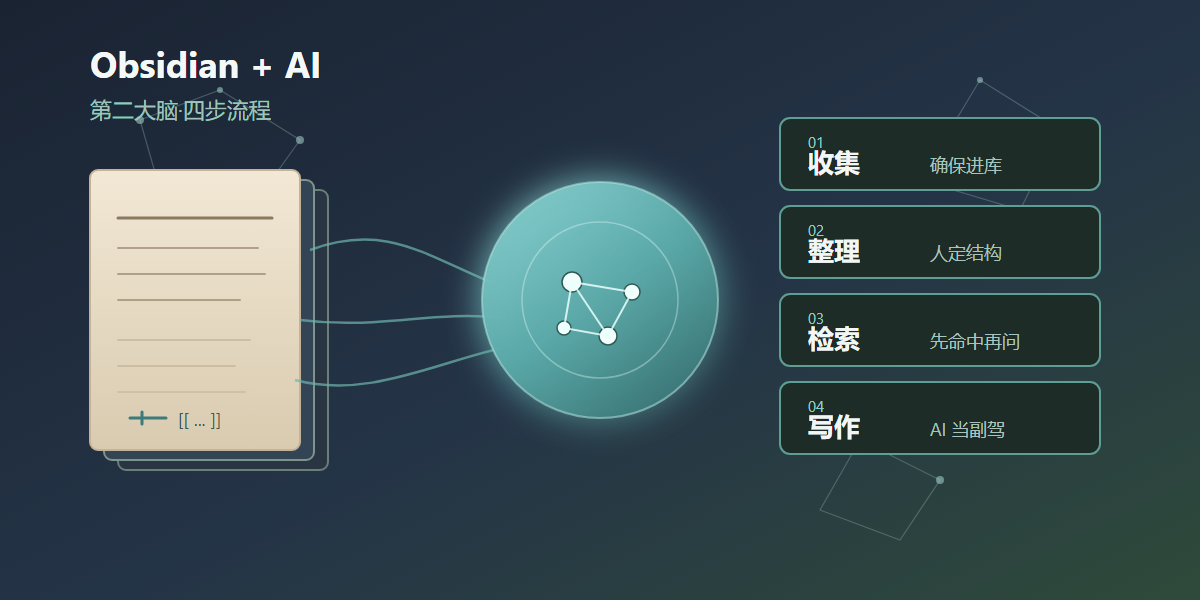
更稳的用法不是追新插件,而是把 Obsidian 当成「第二大脑」的底座,让 AI 只在固定工序里出场。这条工序可以压成四步:收集 → 整理 → 检索 → 写作。下面按步骤说人该盯什么、AI 适合干什么,技术细节只点到够用为止。
收集:先让碎片进库,别急着让 AI 下结论
日常最常见的入口是:会议一句金句、网页一段话、睡前闪过的灵感。目标只有一个——尽快落成一条可找回的笔记,而不是当场写成终稿。Obsidian 里用收件箱文件夹、快速捕获模板,或带来源链接的 Daily Notes 都行;字段别贪多,日期、来源、一句话摘要通常够了。
这一步 AI 适合做「搬运与压缩」:把口语录音稿理成要点、把英文段落译成可读中文、把超长粘贴压成三五条 bullet。不适合做的是:直接判断这条值不值得进长期库、擅自合并多条来源不同的观点。真伪、相关性、是否值得你以后引用——仍是人的活。
举个小例子:你读完一篇行业报告,先把链接和自己划的重点丢进 Inbox,再让 AI 根据你粘贴进去的原文生成「五点摘要 + 待验证问题」。摘要进库,问题挂在文末;结论先别写死,留给整理阶段。
整理:人定结构,AI 帮归类与摘要
第二大脑能不能用,取决于结构是否稳定。文件夹怎么切、标签用粗还是用细、哪些概念值得做成独立笔记并双链——这些规则最好由你定,并且尽量少改。AI 可以在规则之内帮忙:给 Inbox 条目建议目标文件夹、根据正文抽关键词、把杂乱笔记改写成「标题 + 摘要 + 要点」模板。
落地时可以刻意分权:你维护一套模板(例如「概念卡」「书摘」「会议纪要」),AI 只负责往模板里填内容,不擅自发明第三套分类。链接也同理——「这篇跟哪几篇旧笔记相关」可以让 AI 给候选,最终点不点双链由你确认,避免库里出现一堆看起来很聪明、其实没人再点开的空链接。
工作复盘也适用同一套路:一周开了五场会,先把各自纪要留着;周末再用 AI 跨笔记抽出「未关闭的决策 / 重复出现的风险」,写成一页周报笔记,并链回原始会议。压缩的是噪音,原始记录最好还在。
检索:先搜自己的库,再让 AI 基于命中内容说话
这是最容易翻车的一步。很多人直接问聊天窗口:「根据我的笔记,总结一下……」模型若没有真正读到相关文件,就会用通识知识编一段「像你写过」的话。正经顺序应当是:用 Obsidian 搜索、反向链接、图谱或语义检索插件先命中笔记,再把命中片段交给 AI 做综合、对比或答疑。
对应到工具层,思路比品牌重要:本地关键词搜索够用就先用;笔记多了再考虑带嵌入向量的「语义相关」类插件;需要对话式问答时,选那些明确支持「限定 vault / 限定选中文件」的方案。无论用哪家模型,习惯上加一句约束:「只依据下列笔记作答;没有依据就说不知道」——能少很多一本正经的胡话。
检索阶段人的职责是选题与验收:这条答案有没有链回原文?有没有漏掉互相打架的两篇笔记?AI 的职责是汇总与表述。别把「找到该信哪一条」也外包出去。
写作:AI 当副驾,定稿权在你
当你已经有可检索的素材,写作会轻很多。常见节奏是:你拉一张大纲(或让 AI 根据检索结果草案),人改顺序与取舍;再分段扩写、润色语气、生成过渡句;最后通读事实、引用和口吻。Obsidian 里可以在正文旁开一块「素材摘录」区,写完再删,避免草稿和终稿糊在一起。
副驾有边界:不要默认「让 AI 直接改原文并覆盖」。更好的习惯是另存 草稿 或并排 diff,确认后再合并。涉及他人原话、数据、对外承诺的句子,必须回到链接笔记核对。AI 擅长把已有碎片串成可读文章,不擅长替你承担「这句话能不能公开」的责任。
四个阶段:人与 AI 怎么分工
| 阶段 | 人主要做什么 | AI 主要做什么 |
|---|---|---|
| 收集 | 决定是否捕获、补来源与上下文 | 转写、翻译、压缩为要点 |
| 整理 | 定文件夹/标签/模板与双链规则 | 建议归类、填模板、抽摘要 |
| 检索 | 选问题、验收是否依据真实笔记 | 基于命中内容综合、对比、答疑 |
| 写作 | 定立场、结构、事实核对与定稿 | 大纲草案、扩写、润色、过渡 |
先跑通一周,再谈「更聪明」
若库还很乱,不必一次上齐所有 AI 能力。可以按最小路径试七天:每天 Inbox 不超过三条;隔天整理半小时,只允许 AI 按你的模板摘要;周四用搜索(而不是裸聊)回答一个真实问题;周末从命中的三五篇笔记写出一篇短文。跑通之后,再加语义检索或本地模型也不迟。
几个常见坑提前躲开:
- 不检索就生成:看起来像第二大脑,其实是通用聊天。
- 让 AI 直接覆盖原文:出处和口吻容易丢,冲突难回溯。
- 结构每周推倒重来:AI 再勤也补不上不断搬家的成本。
- 把隐私笔记默认送进云端模型:敏感内容优先本地或脱敏后再问。
Obsidian 的优势本来就是本地 Markdown、可链接、可迁移;AI 是加速器,不是新库的主人。流程清晰时,它能明显缩短「从碎片到成稿」的时间;流程缺失时,它只会让噪音扩散得更快。先固定四步分工,再慢慢挑插件——这通常比反过来更省事。